Day4:Logo 之人物设计
- 今日抖音发布:第4集:从零开始做自媒体_Day4:Logo之人物设计
- 今日B站发布:自媒体之路_Day4Logo之人物设计
- 今日Youtube发布:自媒体之路_Day4 Logo之人物设计
- 今日微信公众号发布:自媒体之路 Day 4|两个人站上路径:从爬行废案到青绿定稿
- 今日CSDN发布:做自媒体·第 4 天:给 Logo 加两个小人——四段提示词与三句反馈原文
- 今日头条发布:自媒体之路——Day4:Day4-Logo人物设计
- 今日博客园发布:自媒体起步笔记(四):废掉的方案别删,对的部分别推倒
2026-10-26 · 守民通识 · 自媒体之路
Logo 人物:
在路径上加两个人
Section titled “Logo 人物:在路径上加两个人”上一节做完的 Logo 是一条立体的路径:有厚度、有凸点、有箭头、有三层颜色。这一节要在它上面加两个人——起点一个站着看书的,终点一个坐着想事的。路径是 NX 画的,人是豆包生成的,最后用 WorkBuddy 把两者合到一张图里。全篇 29 步,每一步都写清在哪个界面、点哪里、发什么原文、怎么判断这一步做对了没有。
本节数据:10 节 · 29 个步骤 · 25 张图 · 2026-10-26 06:15–07:05 · 豆包 + WorkBuddy
本页内容索引
Section titled “本页内容索引”- 01 · 路径上还缺两个人:先存一张比对用的图
- 02 · 先在导图里记下来:五批候选存在哪
- 03 · 先试爬行,结果不能用:两个原因要分开记
- 04 · 换成站着看书:一次出八张,从里面挑一张
- 05 · 终点那个人:四种姿势各跑一批,摆一起比
- 06 · 把四个文件一起交给 AI:一句话要写全四件事
- 07 · 第一版偏了三处:跟基准图一项一项比
- 08 · 只补缺的,别重写:加一句话,第二版就对了
- 09 · 形状定了再换颜色:三轮试色,模型没动
- 10 · 最后加字,没过关:问题在字的笔画太细
- 知识地图进度(截至 Day 4)
- 尾声
01 · 路径上还缺两个人:先存一张比对用的图
Section titled “01 · 路径上还缺两个人:先存一张比对用的图”对应解说词第 1–20 句。
打开上一节的文件,先确认三样东西还在:路径有厚度、凸点按等距排好、箭头刻在面上。这三样都在,说明路径本身做完了,这一节不用再改它。然后再看整张图——上面一个人也没有。要加的两个人,位置已经定好:一个站在箭头开始的那一端,一个坐在最后箭头指向的绿圆上。
步骤 1:打开上一节的模型,看看还差什么
Section titled “步骤 1:打开上一节的模型,看看还差什么”打开上一节做好的 Logo,检查三件事:带体有厚度、凸点按等弧长排、箭头刻在面上。三件都对,说明路径本身不用再改了。接着看整张图:只有一条路,没有一个人。这一次要补的就是这个——在起点和终点各站一个角色。
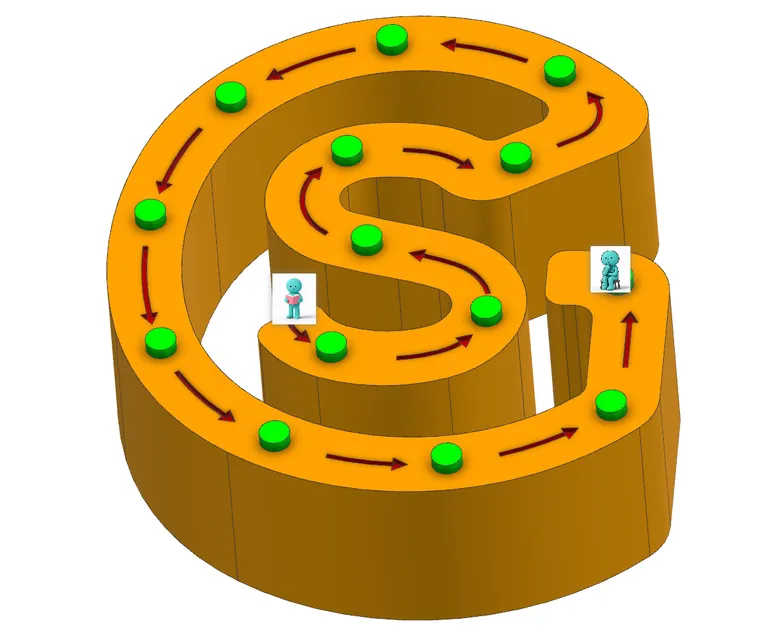
上一节做完的路径 · 有厚度、有凸点、有刻痕,上面没有人
步骤 2:把这个状态单独存成一张图,后面一直拿它比
Section titled “步骤 2:把这个状态单独存成一张图,后面一直拿它比”在 NX 里把视图摆正,导出一张 PNG,命名 想要的完整logo.png,要求白底、无阴影、正视角。这张图不是最终成品,是后面每次 AI 出图之后用来比对的样张:人的大小对不对、位置偏没偏,都拿它量。已经定稿的东西先单独存一份,不然改到第三版就说不清是哪一步变了的。
技巧 为什么必须白底、正视角:AI 认位置靠图上的两个参照物——箭头开始的那一端、最后箭头指向的绿圆。图是斜的或者带背景,它就会认错这两个点。
02 · 先在导图里记下来:五批候选存在哪
Section titled “02 · 先在导图里记下来:五批候选存在哪”对应解说词第 21–40 句。
这一段没有直接画图,先回到思维导图。因为这一节要留下的不只是一个模型,还有五批候选图和一条选用记录:谁放在什么位置、试了哪几种姿势、哪一版废了、最后用哪个。这些东西得有地方存,不然过两天自己都说不清。
步骤 3:在「思路」下面新建一条
Section titled “步骤 3:在「思路」下面新建一条”打开 守民通识导图.mmap,沿 自媒体之路 → 00 准备阶段 → Logo设计 → 思路 往下走。选中「思路」,按 Insert 建子主题,输入:利用豆包AI生成路径上的小人。 「思路」下原来有「借助豆包AI生成频道简介」「使用NX绘制Logo」两条,新建的这条和它们同级,排在最下面。
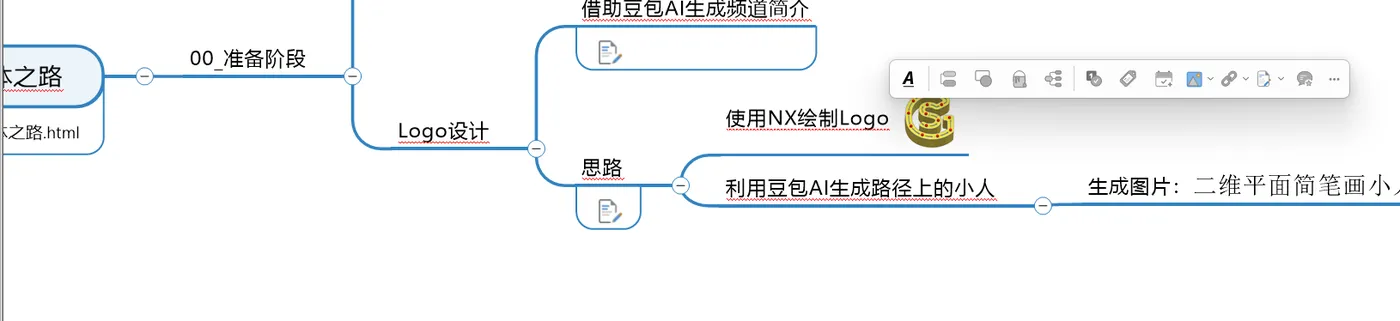
「思路」下第三条分支 · 新节点和原来两条同级
步骤 4:再拆成「起点」「终点」两支
Section titled “步骤 4:再拆成「起点」「终点」两支”上一步那个节点只说了要生成小人,没说几个、放在哪儿。选中它,按 Insert 再建两个子主题: 用于路径起点的小人、用于路径终点的小人。分成两支之后,后面每生成一批图,都知道该挂到哪一边,不会全堆在同一个节点上。
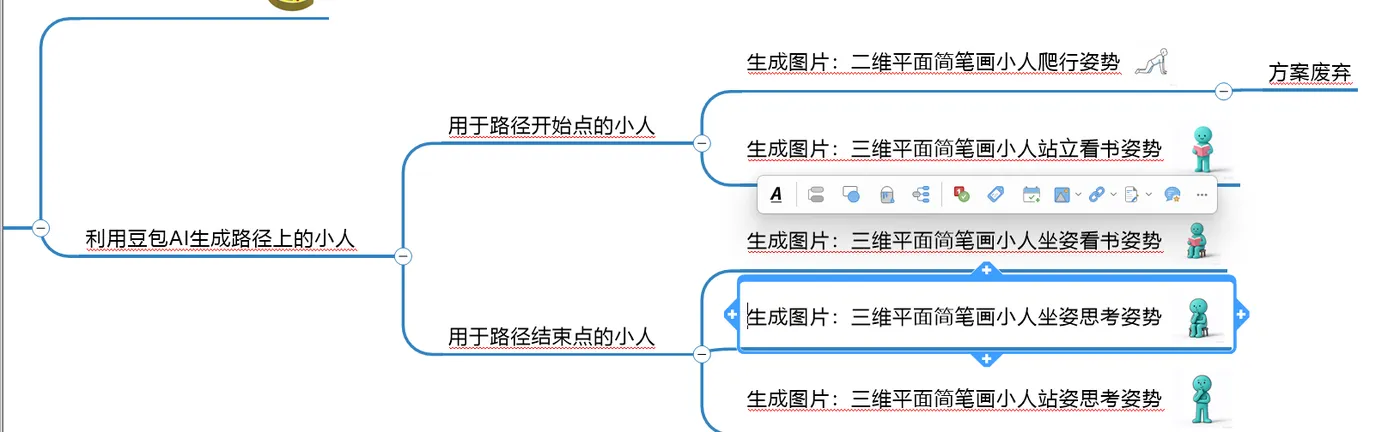
分成起点、终点两支 · 后面每批图各挂各的
步骤 5:生成的图,用「添加图像」挂到节点上
Section titled “步骤 5:生成的图,用「添加图像」挂到节点上”选中要挂图的节点,在功能区点 图片 → 添加图像(也可以右键选「添加图像」),在弹出的文件框里选刚存下来的 PNG。 MindManager 会把图缩成缩略图贴在节点右侧,鼠标移上去能放大。
这一步看着琐碎,用处是让每张候选都对得上位置:图挂在哪个节点下,就说明它是给哪个位置生成的;哪天要换,知道该重跑哪一批。
添加图像 · 选的是刚存下来的 PNG,不是截图
步骤 6:五批挂完,节点下面就是一份候选清单
Section titled “步骤 6:五批挂完,节点下面就是一份候选清单”每跑完一批就挂一张,最后这个节点下会排成五行:爬行、站立看书、坐姿看书、坐姿思考、站姿思考,每行右边一个缩略图。这时不用开文件夹翻,导图本身就是候选清单。
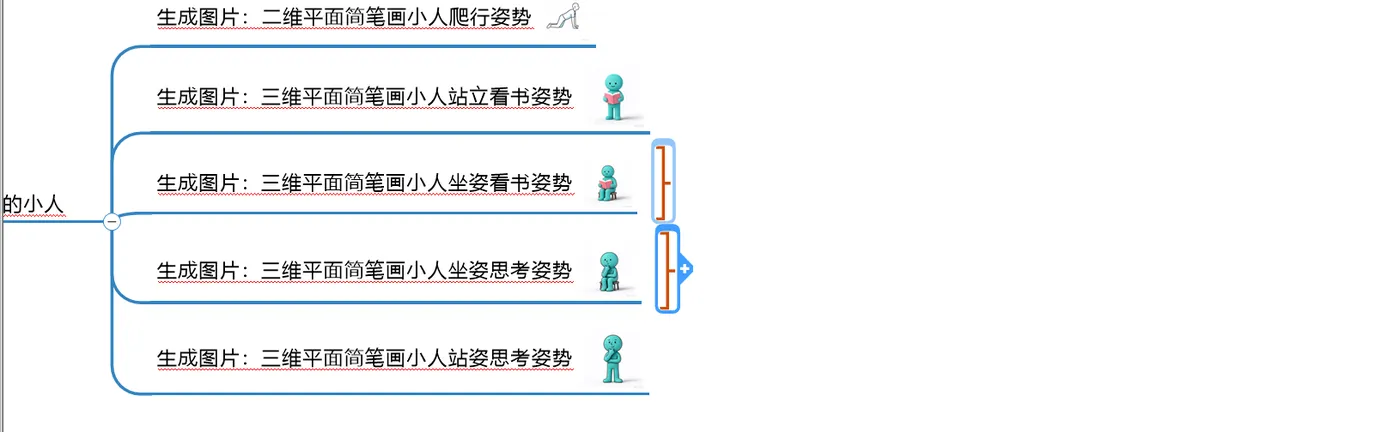
五行候选并排 · 缩略图直接贴在节点右侧
步骤 7:爬行那版不用了,标「方案废弃」,别删
Section titled “步骤 7:爬行那版不用了,标「方案废弃」,别删”爬行那一版最后没用,但别删节点——删了就说不清「为什么最后不用爬行」。选中它,按 Enter 建一个同级主题,写 方案废弃,让两者用连线牵着。整段导图里,废弃的和在用的要能一眼分开。
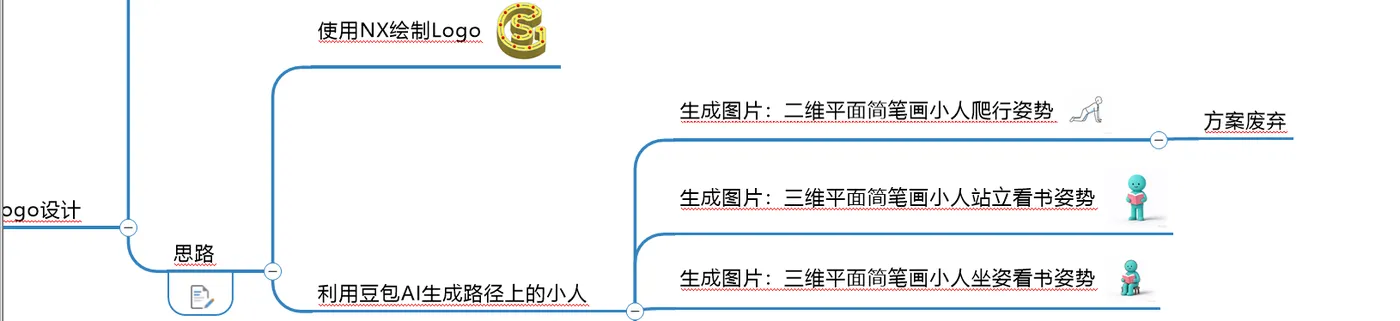
废弃不删 · 留着才能解释为什么换方案
03 · 先试爬行,结果不能用:两个原因要分开记
Section titled “03 · 先试爬行,结果不能用:两个原因要分开记”对应解说词第 41–56 句。
最初的想法是一条成长线:从爬行开始,慢慢站起来走,最后是白发老人。所以第一条提示词写的就是爬行。这一版最后废掉了,废在两个不同的原因上——分开记,下次才知道该往哪边改。
步骤 8:在豆包里发第一句:二维平面简笔画 + 爬行
Section titled “步骤 8:在豆包里发第一句:二维平面简笔画 + 爬行”打开豆包,新建对话,把这句原样发过去:
生成图片:二维平面简笔画小人爬行姿势,动物形象,这些图为简笔画风格,线条简洁,每张都展示了同一小人爬行姿势的不同视角和角度。它会给四张,同一个姿势的不同角度。这句话里其实已经写了两层要求:风格(二维平面、简笔画、线条简洁)和数量(多角度、每张视角不同)。
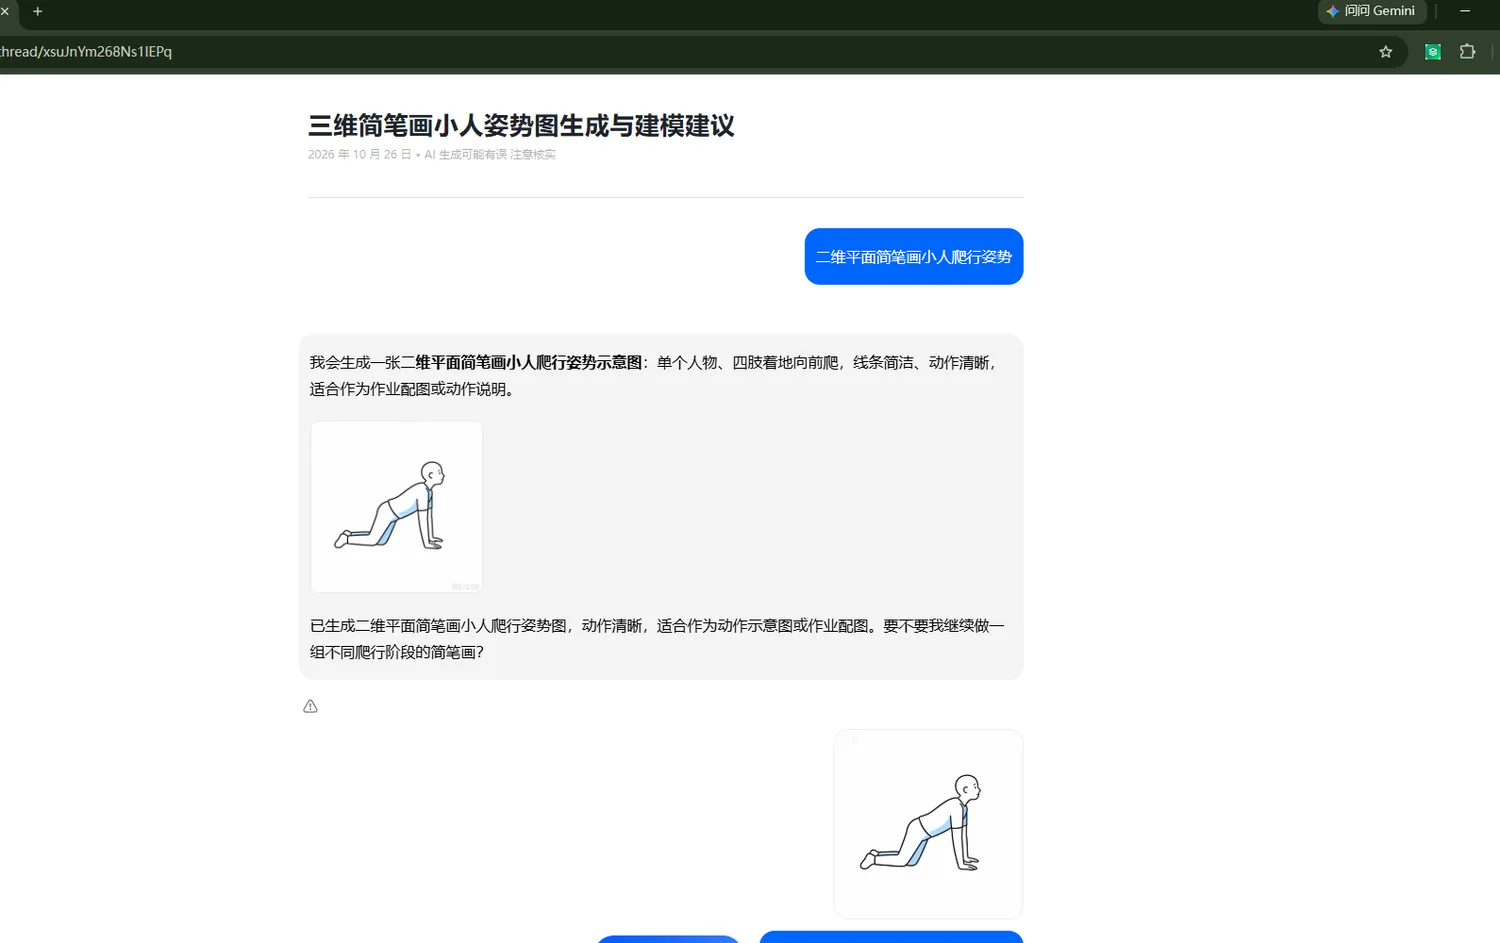
第一条和第二条在同一个对话里 · 简化是接着改,不是新开一单
步骤 9:把图缩到 40 像素再看,别按原尺寸判断
Section titled “步骤 9:把图缩到 40 像素再看,别按原尺寸判断”别在原尺寸下看。这批图最后放在 Logo 里只占很小一块,大约 40 像素高。把结果缩到这个尺寸:线条糊成一片灰的,就是线条密度没真降下来——它嘴上说「简笔画」,画出来还是细密的轮廓线。
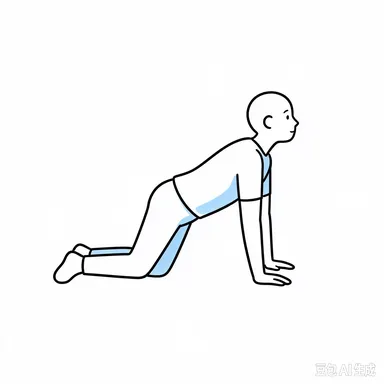
爬行第一版 · 姿势对,线条太密
步骤 10:在同一个对话里补一句:线条太复杂,简化一下
Section titled “步骤 10:在同一个对话里补一句:线条太复杂,简化一下”接着发:生成的图片线条太复杂了,简化一下。在同一个对话里发,它才带着上一张改;新开一个对话,等于让它从零重猜。
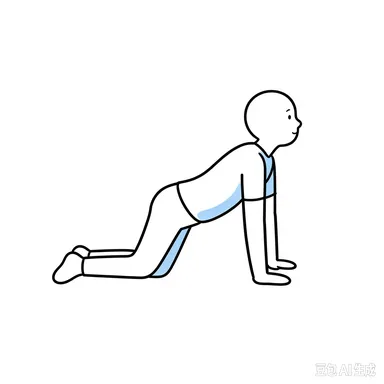
简化版 · 线少了,姿势一点没动
步骤 11:简化后还是差不多,说明该换姿势了
Section titled “步骤 11:简化后还是差不多,说明该换姿势了”把两张并排看,差别只有几条线。简化改的是线条,不改姿势——想换姿势只能重新发一句,把词换掉。同时另一条也成立:爬行这个动作放在一条往上去的路径起点上,读不出「在学东西」的意思。所以整版放弃,导图里标「方案废弃」。
技巧 两个原因分开记:线条太密,是风格没写够,加限定词能修;姿势不对,是内容不对,只能换词重来。混成一件事,下次还会在同一个地方改三遍。
04 · 换成站着看书:一次出八张,从里面挑一张
Section titled “04 · 换成站着看书:一次出八张,从里面挑一张”对应解说词第 57–70 句。
从「爬」改到「站」,换的不只是一个动作。站着捧一本书,这个动作本身就能读出「在学东西」;人是竖着的,和往上走的路径方向也一致,放上去不用转角度。
步骤 12:提示词改三处:二维改三维、爬行改站立看书、角度写全
Section titled “步骤 12:提示词改三处:二维改三维、爬行改站立看书、角度写全”新发一句,重点改三处:二维 → 三维平面、爬行 → 站立看书、把角度写全:
生成图片:一张三维平面简笔画小人站立看书姿势,可以从几个角度:转身侧面、侧面背面、侧面正面、俯视、半侧面、正面,这些角度生成 8 张。加「三维平面」是为了和路径模型的渲染风格对上;写全六个角度,是为了让它真的换角度,而不是同一张重画八遍。
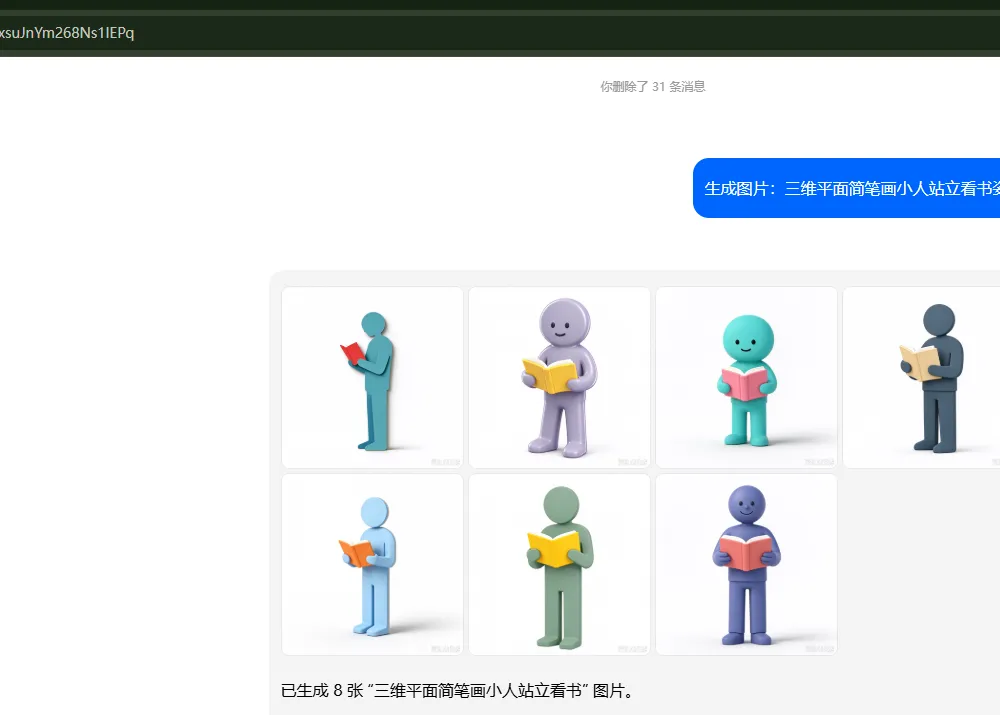
一次出八张 · 从变体里挑,不是等一次就中
步骤 13:八张怎么挑:先看配色,再看缩小后还认不认得出
Section titled “步骤 13:八张怎么挑:先看配色,再看缩小后还认不认得出”八张的姿势都合格,差别在配色和体态。分两步筛:
- 先看配色:这一批里青绿那版和后面要用的底座颜色最接近,先留下。
- 再看缩小以后:缩到 40 像素,还认得出「站着、捧着一本书」,才算过。四肢太细、书太小的,缩小后就散了。
最后选的是青绿色、捧着粉书那张。八格里有一格是空的(第八格没渲染出来),不影响挑——不用为了这一格重跑整批。
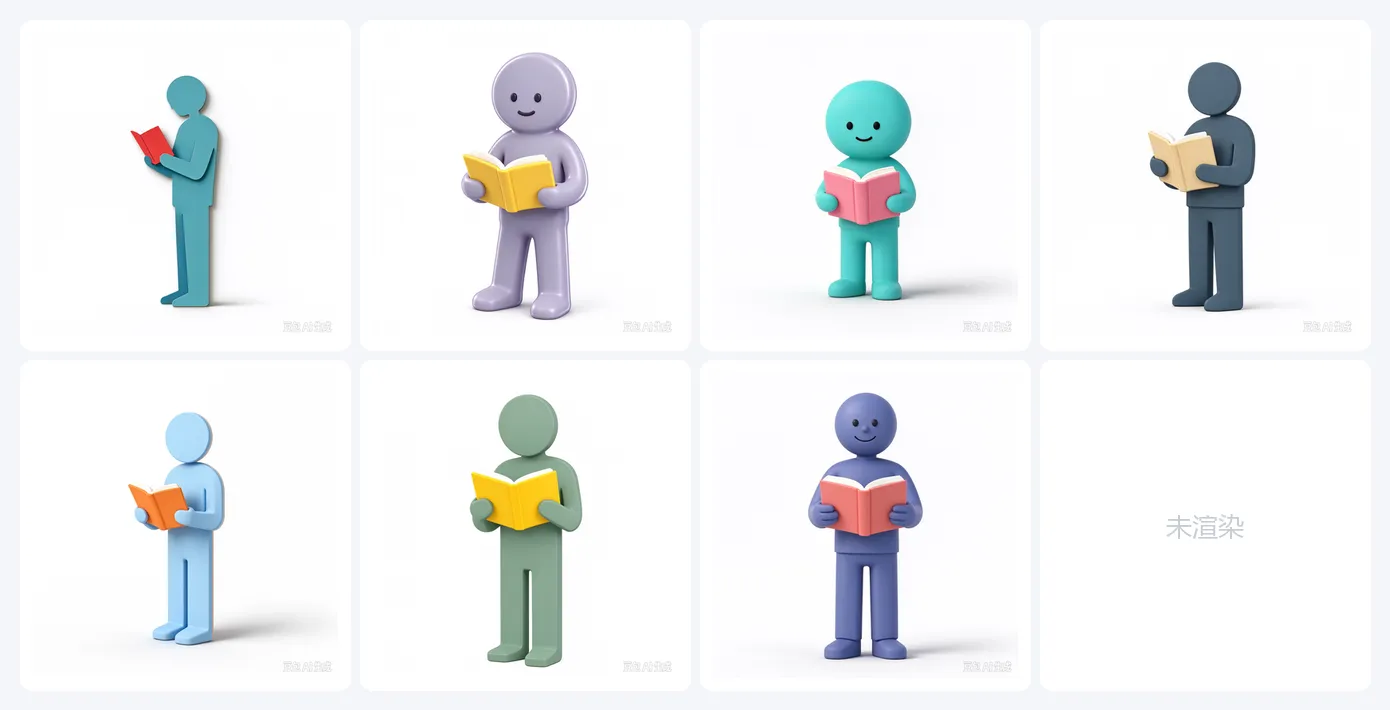
七张候选 · 第八格没渲染出来,不影响选
步骤 14:存成能看懂的文件名
Section titled “步骤 14:存成能看懂的文件名”存成 三维平面简笔画小人站立姿势.png,透明底。文件名里三件事都在:风格(三维平面简笔画)、内容(站立姿势)、用途(下一步要在提示词里点名这个文件)。如果起成「新建图片 3.png」,下一步就没法在提示词里指它。
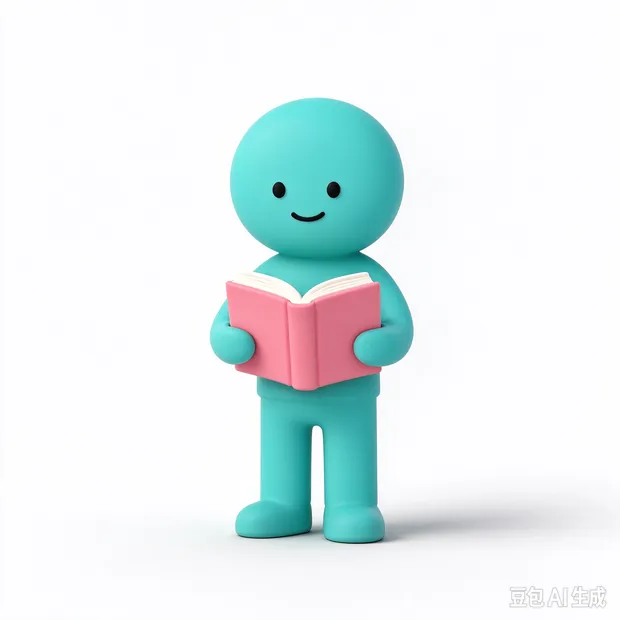
选中的这张 · 青绿身体、粉书、微笑
05 · 终点那个人:四种姿势各跑一批,摆一起比
Section titled “05 · 终点那个人:四种姿势各跑一批,摆一起比”对应解说词第 71–92 句。
起点的人是「正要开始」,终点的人得是「已经想过」。所以终点的姿势不能只是站着,要有一个停下来动脑子的样子。这一段连着跑了四批,最后只用一张,另外三张是用来排除的——没有它们,说不清为什么留这张。
步骤 15:只换姿势一个词,其他都不动
Section titled “步骤 15:只换姿势一个词,其他都不动”把提示词里的姿势换掉,其余不动——风格词不动、角度词不动、数量不动。换的只有「站立看书 → 坐姿看书」。
生成图片:一张二维平面简笔画小人坐姿看书姿势,动物形象,可以从几个角度:转身侧面、侧面背面、侧面正面、俯视、半侧面、正面,这些角度生成 8 张。只换一个词,是为了让前后两批能比:同一套风格、同一套角度,唯一的差别就是姿势。
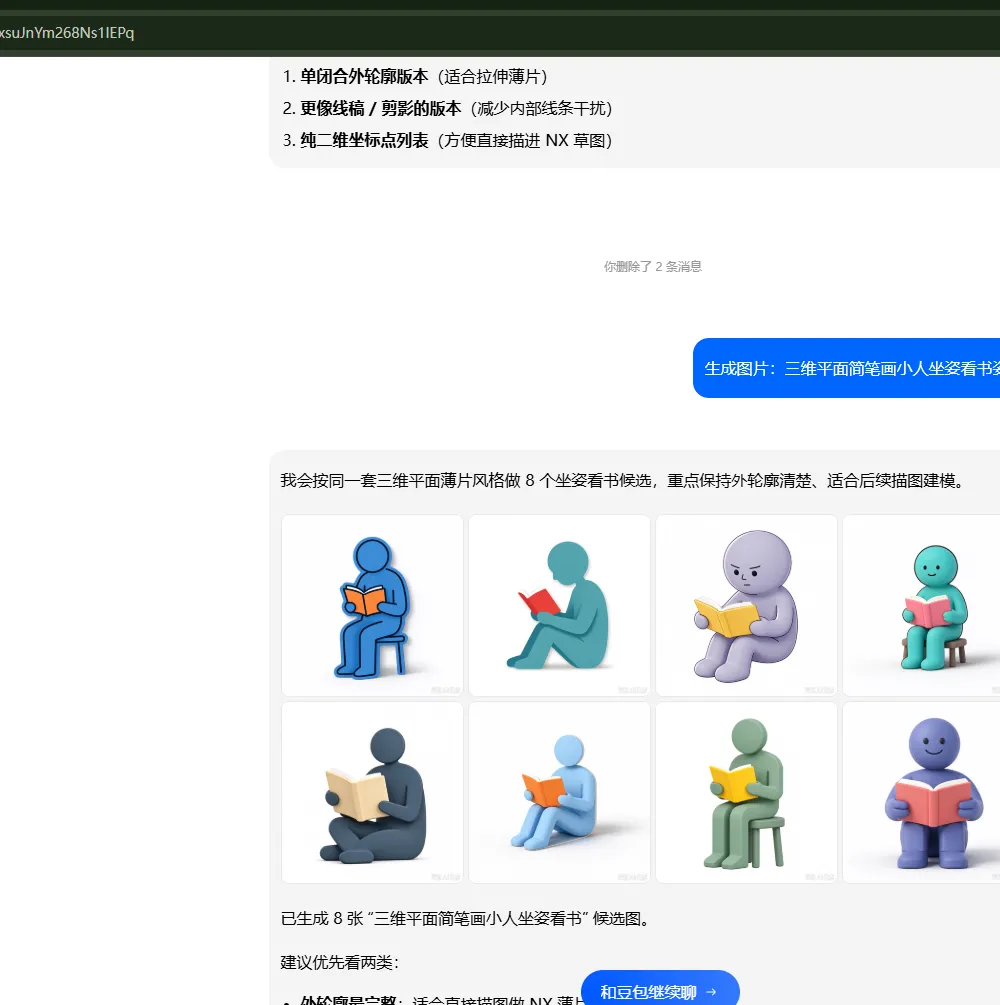
坐姿那一批 · 只换了姿势一个词
步骤 16:再跑一批「坐着想事」,把「站着想事」也留着
Section titled “步骤 16:再跑一批「坐着想事」,把「站着想事」也留着”「坐着看书」和「坐着想事」是两个状态:前者还在往里看,后者已经想完了。终点在路径的尽头,更该是后面那个。所以再跑一批 坐姿思考,顺手把 站姿思考 也留住。
技巧 多跑几批不是为了碰运气,是把能选的都摆到面前。四张一起看,才说得出为什么留这张。
步骤 17:四张摆一起看,哪个接得住「终点」
Section titled “步骤 17:四张摆一起看,哪个接得住「终点」”四张放在一起,读法很清楚:站立看书是「刚开始」、坐着看是「停下了」、坐着想是「想过了」、站着想是「还在想」。路径是往上走到尽头的,终点要有收住的感觉,所以坐着比站着合适;到了最后一站,所以「想过了」比「还在看」合适。
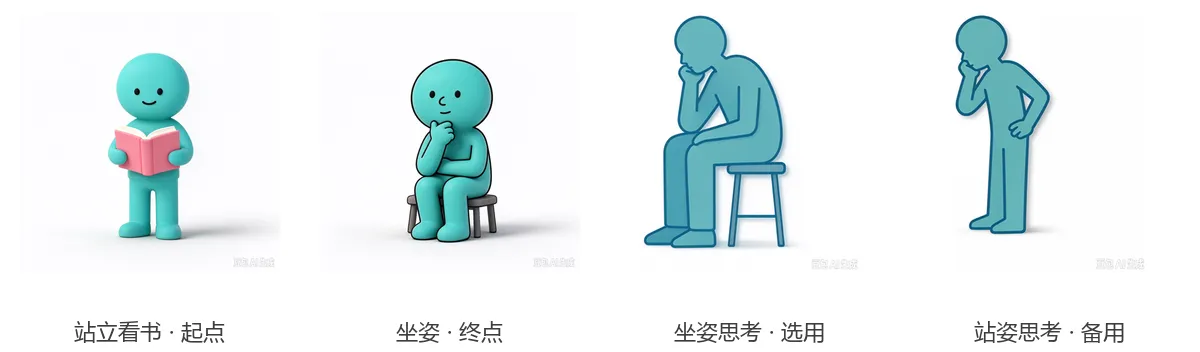
四种姿势 · 站立看书 / 坐姿 / 坐姿思考 / 站姿思考
步骤 18:定下坐姿思考,顺手记一条:它自带一张小板凳
Section titled “步骤 18:定下坐姿思考,顺手记一条:它自带一张小板凳”最后选 坐姿思考,存成 二维平面简笔画小人坐姿势.png。注意这张图里小人坐的是一张小板凳——合成时这张板凳要处理掉,因为终点本来就有绿圆台可以当座位。这一条要记下来,下一步写提示词时用得上。
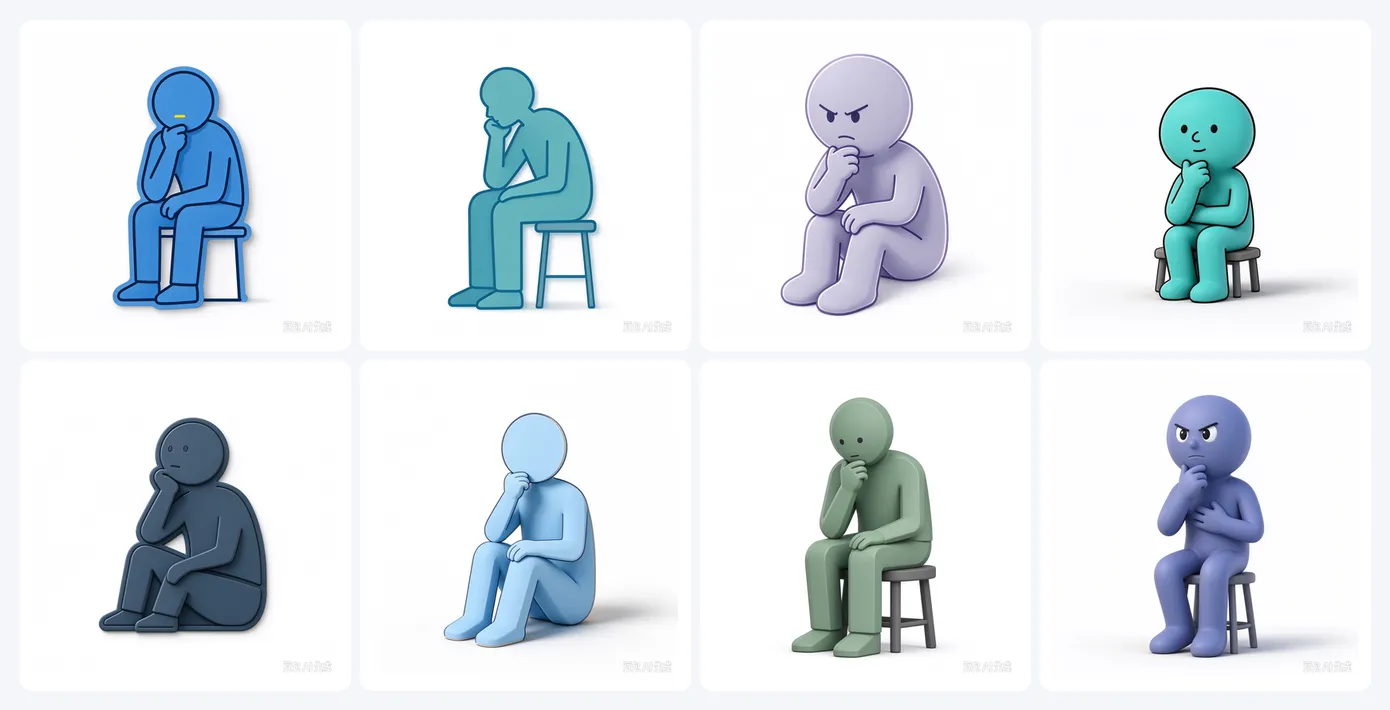
坐姿思考八张 · 选中间那张,注意它自带一张小板凳
06 · 把四个文件一起交给 AI:一句话要写全四件事
Section titled “06 · 把四个文件一起交给 AI:一句话要写全四件事”对应解说词第 93–104 句。
人有了,路径模型也有了,剩下是合到一起。这一步不画图,只写一句话。这句话写不全,后面就得多跑三四版。
步骤 19:四个文件一起拖进对话框
Section titled “步骤 19:四个文件一起拖进对话框”打开 WorkBuddy,把四个文件一起拖进对话框:shoumingeneralist_logo.prt(路径模型)、 三维平面简笔画小人站立姿势.png、二维平面简笔画小人坐姿势.png、想要的完整logo.png(比对用的那张)。
第四个文件最容易被漏掉,但它恰恰是大小和位置的唯一依据——AI 没有它,只能凭感觉放大缩小。
步骤 20:这句话必须写全四件事
Section titled “步骤 20:这句话必须写全四件事”原文照抄如下:
将这个 stp 文件渲染成一个科普类自媒体的 logo,同时渲染时将站立的小人放在箭头开始端,将坐着的小人放在最后箭头指向的绿圆上,替换掉坐姿小人图中的小板凳。融合在一起渲染。四件事分别是:
- 用哪个文件——stp,也就是那个 .prt 导出的模型。
- 做成什么——渲染成一个科普类自媒体的 logo。
- 谁放在哪个点——站立的小人放箭头开始端,坐着的小人放最后箭头指向的绿圆。
- 替换掉什么——坐姿小人自带的那张小板凳。
位置要写图上现成的参照物(箭头开始端、最后箭头指向的绿圆),不能写「放好看点」「放在合适的位置」。参照物是它能认的,形容词它只能猜。
四个文件 + 一句话 · 附件标签就贴在气泡上方
步骤 21:先读它回的那份「实现效果」,再看图
Section titled “步骤 21:先读它回的那份「实现效果」,再看图”它跑完会给一段回复,里面列了「实现效果」:站立小人放在起点端、坐着小人放在终点绿圆、两个绿圆加高形成座位、光影和色调统一。这份清单比图更快看出它理解得对不对——清单里写错的地方,图上一定也错。
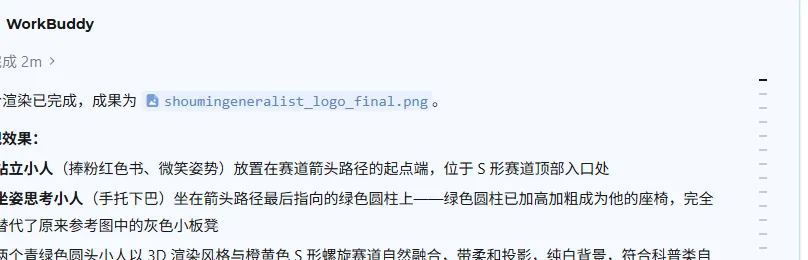
回复里的实现效果 · 一条一条对着自己的要求读
07 · 第一版偏了三处:跟基准图一项一项比
Section titled “07 · 第一版偏了三处:跟基准图一项一项比”对应解说词第 105–108 句。
图出来了,不能只说一句「不好看」。要说清哪一项不对、偏成什么样,不然下一句它不知道该改哪儿。
步骤 22:并排比三项:大小、位置、光影
Section titled “步骤 22:并排比三项:大小、位置、光影”把结果和刚才那张 想要的完整logo.png 并排,比三项。第一版三项都偏,而且偏的方向不一样:
- 人太大——小人差不多是基准图里的一倍大,把路径本身压住了。
- 位置也不对——站的应该在箭头开始那一端,结果站在了路径中间;终点那个绿圆还被放大了。
- 没有渲染——只把两个图拼到一起,没加光影、没调色,人和路径像两张图贴在一起。
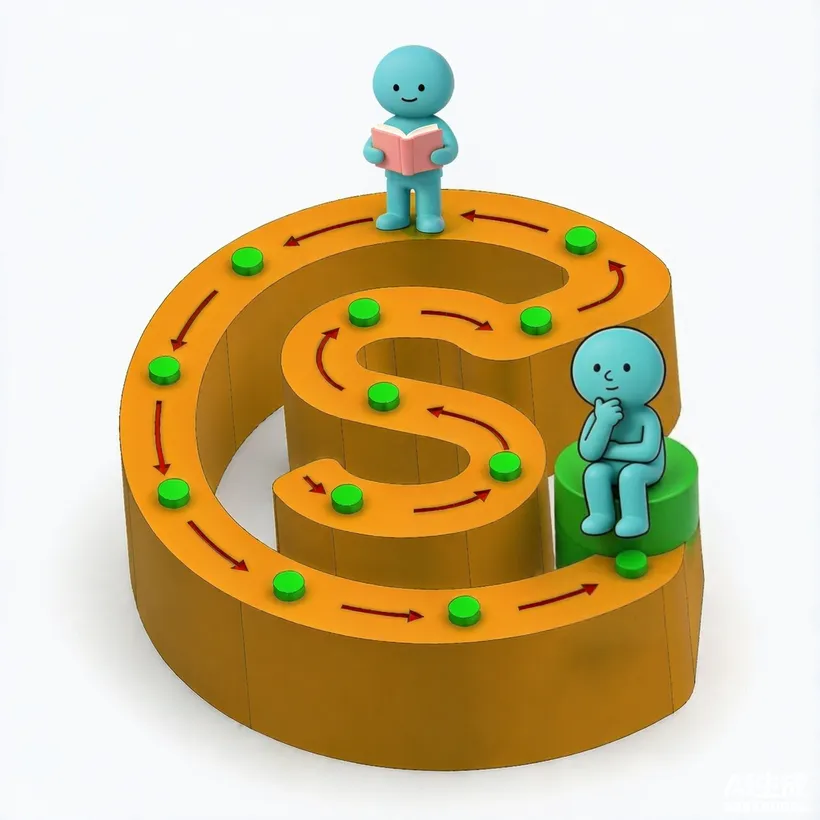
第一版 · 人偏大、位置偏、没有光影
步骤 23:前两项说数字,第三项说工序
Section titled “步骤 23:前两项说数字,第三项说工序”三处错误里,前两处是可以量出来的:大小按基准图的比例改,位置按图上的参照物放。第三处是少了工序:要光影、要调色、要和路径一个渲染风格。反馈按这个顺序说,它才知道哪些是「改数字」,哪些是「补一步没做的」。
08 · 只补缺的,别重写:加一句话,第二版就对了
Section titled “08 · 只补缺的,别重写:加一句话,第二版就对了”对应解说词第 109–112 句。
第一版不是全错:路径没变形、凸点还在、箭头方向也对。所以反馈只补缺的那三处,不要把提示词重发一遍。
步骤 24:接着上一版发一条反馈,原文三句
Section titled “步骤 24:接着上一版发一条反馈,原文三句”在同一个对话里接着发:
不对,完全偏离需求,小人要很小,需要按照「想要的完整logo.png」给定的比例和位置,而且图片也没有渲染呀,没有光影和调色呀。三句话对应三处错误,而且都用了刚才上传的那张基准图当依据——「按照想要的完整logo.png给定的比例和位置」,它就不用再猜多大了。
技巧 为什么不能重写提示词:重写等于从零开始,第一版里已经对的部分(路径没变形、凸点还在)会被一起丢掉,它得从头再猜一遍。接着上一版提要求,是在现有结果上改局部,对的地方留着。
反馈原文 · 三句话对三处错误
步骤 25:第二版:位置、大小、光影都对上了
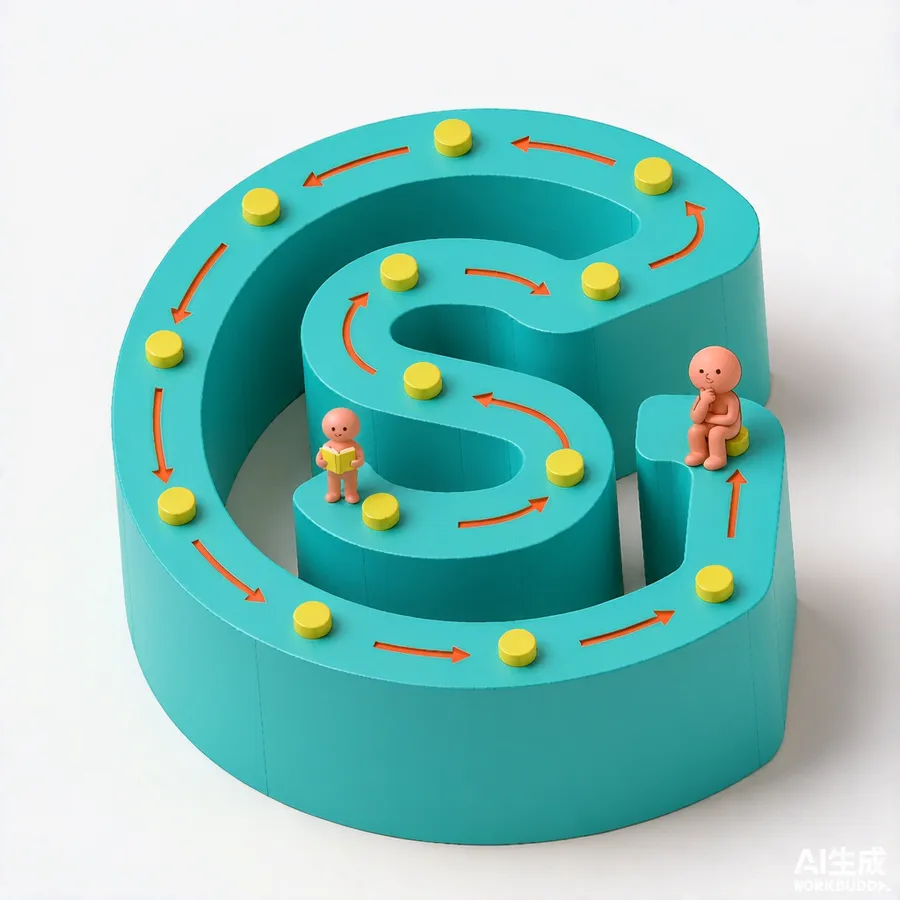
Section titled “步骤 25:第二版:位置、大小、光影都对上了”第二版:站立小人落到箭头开始那一端,坐着小人坐到终点绿圆上,大小按基准图缩下来,光影和路径统一了。只补了一句要求,两版就收敛。
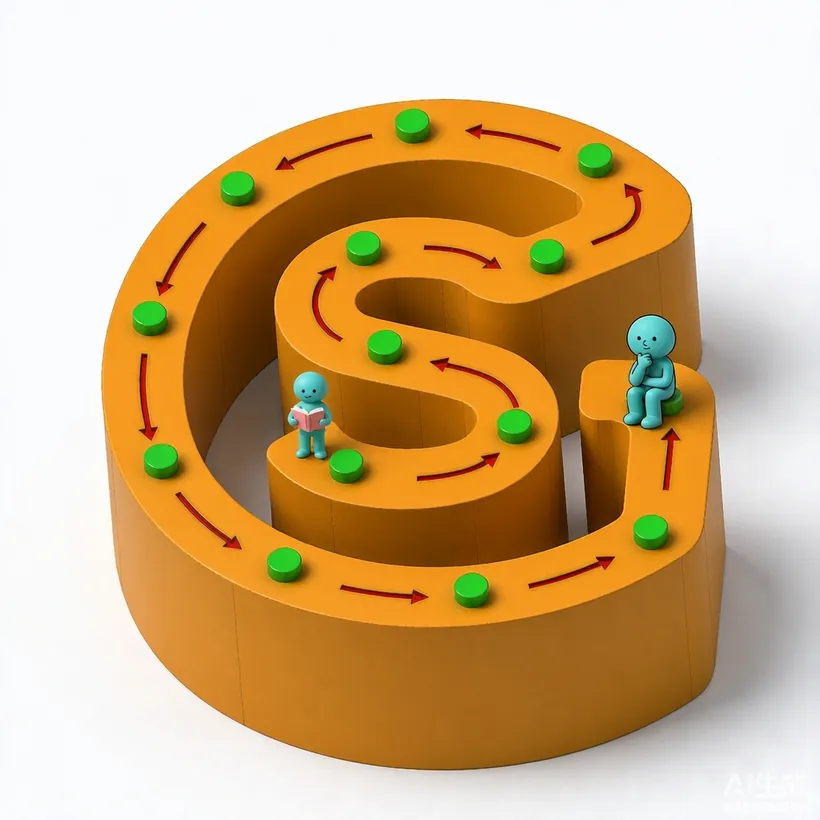
第二版 · 起点站着、终点坐着,大小和光影都对了
09 · 形状定了再换颜色:三轮试色,模型没动
Section titled “09 · 形状定了再换颜色:三轮试色,模型没动”对应解说词第 113–117 句。
形状和位置定下来之后,换颜色就是件便宜事:只改色调,模型、人的位置、凸点排布都不动。反过来,形状还没定就换色,每换一次都得重新确认一遍「还是不是原来那个东西」。
步骤 26:第一轮:压深,试深灰蓝
Section titled “步骤 26:第一轮:压深,试深灰蓝”在第二版的基础上改色调,压成深灰蓝。这一版优点是稳,问题是底色一暗,凸点和刻痕的层次就糊掉了。
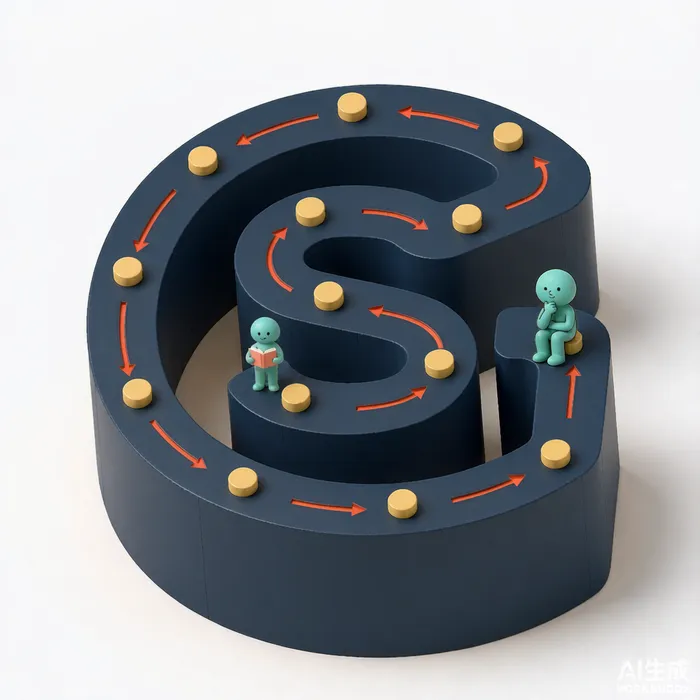
深灰蓝 · 稳,但凸点的对比被压掉一部分
步骤 27:第二轮:提亮,青绿做主色
Section titled “步骤 27:第二轮:提亮,青绿做主色”再提亮一档,换成青绿为主色。这一版三个层次重新分开了:底座是青绿,凸点是暖黄,刻痕是深色。和「求知」这个题目也更贴——绿色偏生长。
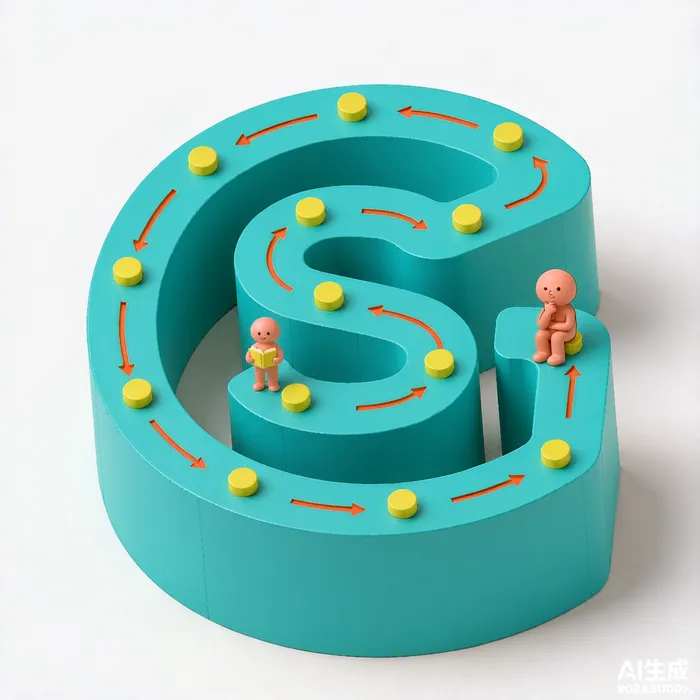
青绿 + 金黄 · 三个层次分得最开,最终选这一版
步骤 28:第三轮:试紫绿,作为对照
Section titled “步骤 28:第三轮:试紫绿,作为对照”再试一版紫调。紫绿也能看,但紫的冷感偏「科技」,和「通识、学习」的调子差一层。三轮并排一看,选青绿那版。
技巧 三轮改下来,路径的形状、人的位置、凸点的排布一次都没动——这就是第 07、08 节先把形状定下来的用处。
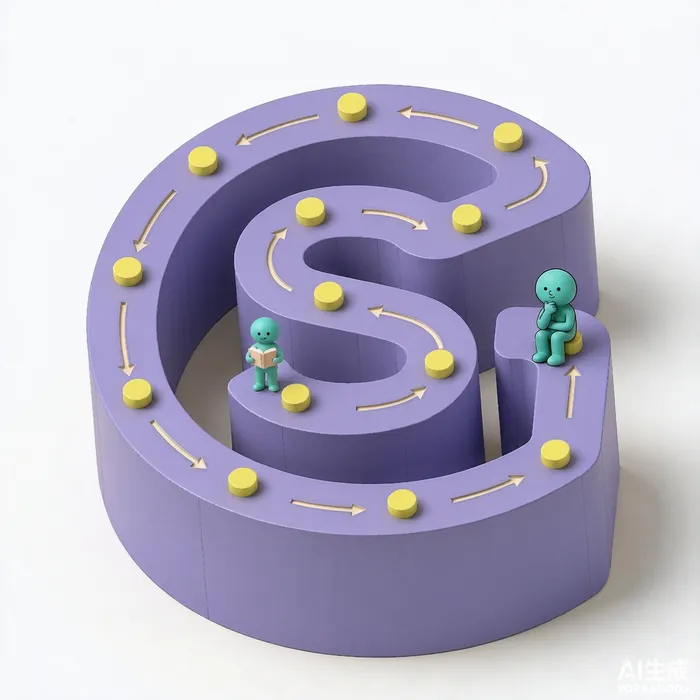
紫绿 · 形状一致,只换了颜色
10 · 最后加字,没过关:问题在字的笔画太细
Section titled “10 · 最后加字,没过关:问题在字的笔画太细”对应解说词第 118–120 句。
图形部分到这里算成立。最后一步是把频道名压上去,这一关没过——如实记下来,比硬选一个好。
步骤 29:四种排法都试了,问题不在怎么摆
Section titled “步骤 29:四种排法都试了,问题不在怎么摆”一次排了四种:繁体横版(图标在左、字在右)、简体横版、竖版(图标在上、字在下)、深色底反白。四种摆在一起,问题就出来了:图形是一个有厚度的立体物,字是平的、细的——两者不在一个重量上。字小一点,像标签贴上去;字大一点,又压过图形。
所以这一节到图形为止。字标留到下一节单独解决:先把笔画做出同样的重量,再谈怎么摆。
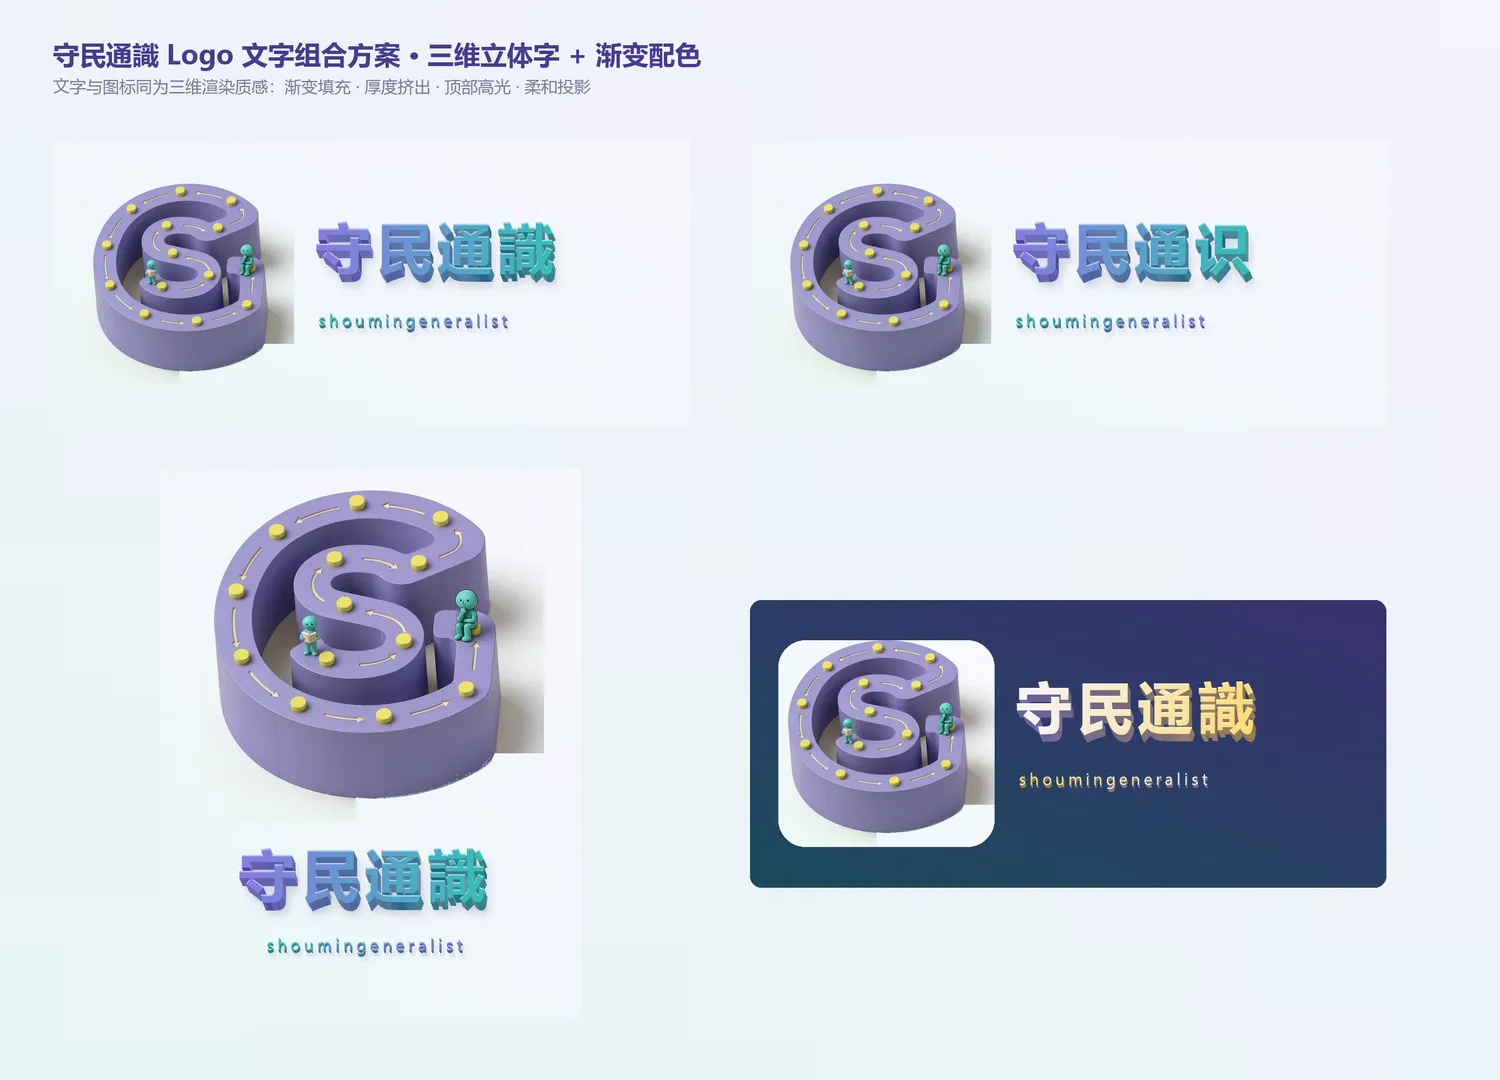
四种排法 · 图形有厚度,字是平的,重量对不上
知识地图进度(截至 Day 4)
Section titled “知识地图进度(截至 Day 4)”下图是「守民通识导图」截至本篇(Day 4)已经长出来的部分。后面几天才会补的节点这里不画出来——每篇只展示到当篇更新到的位置。
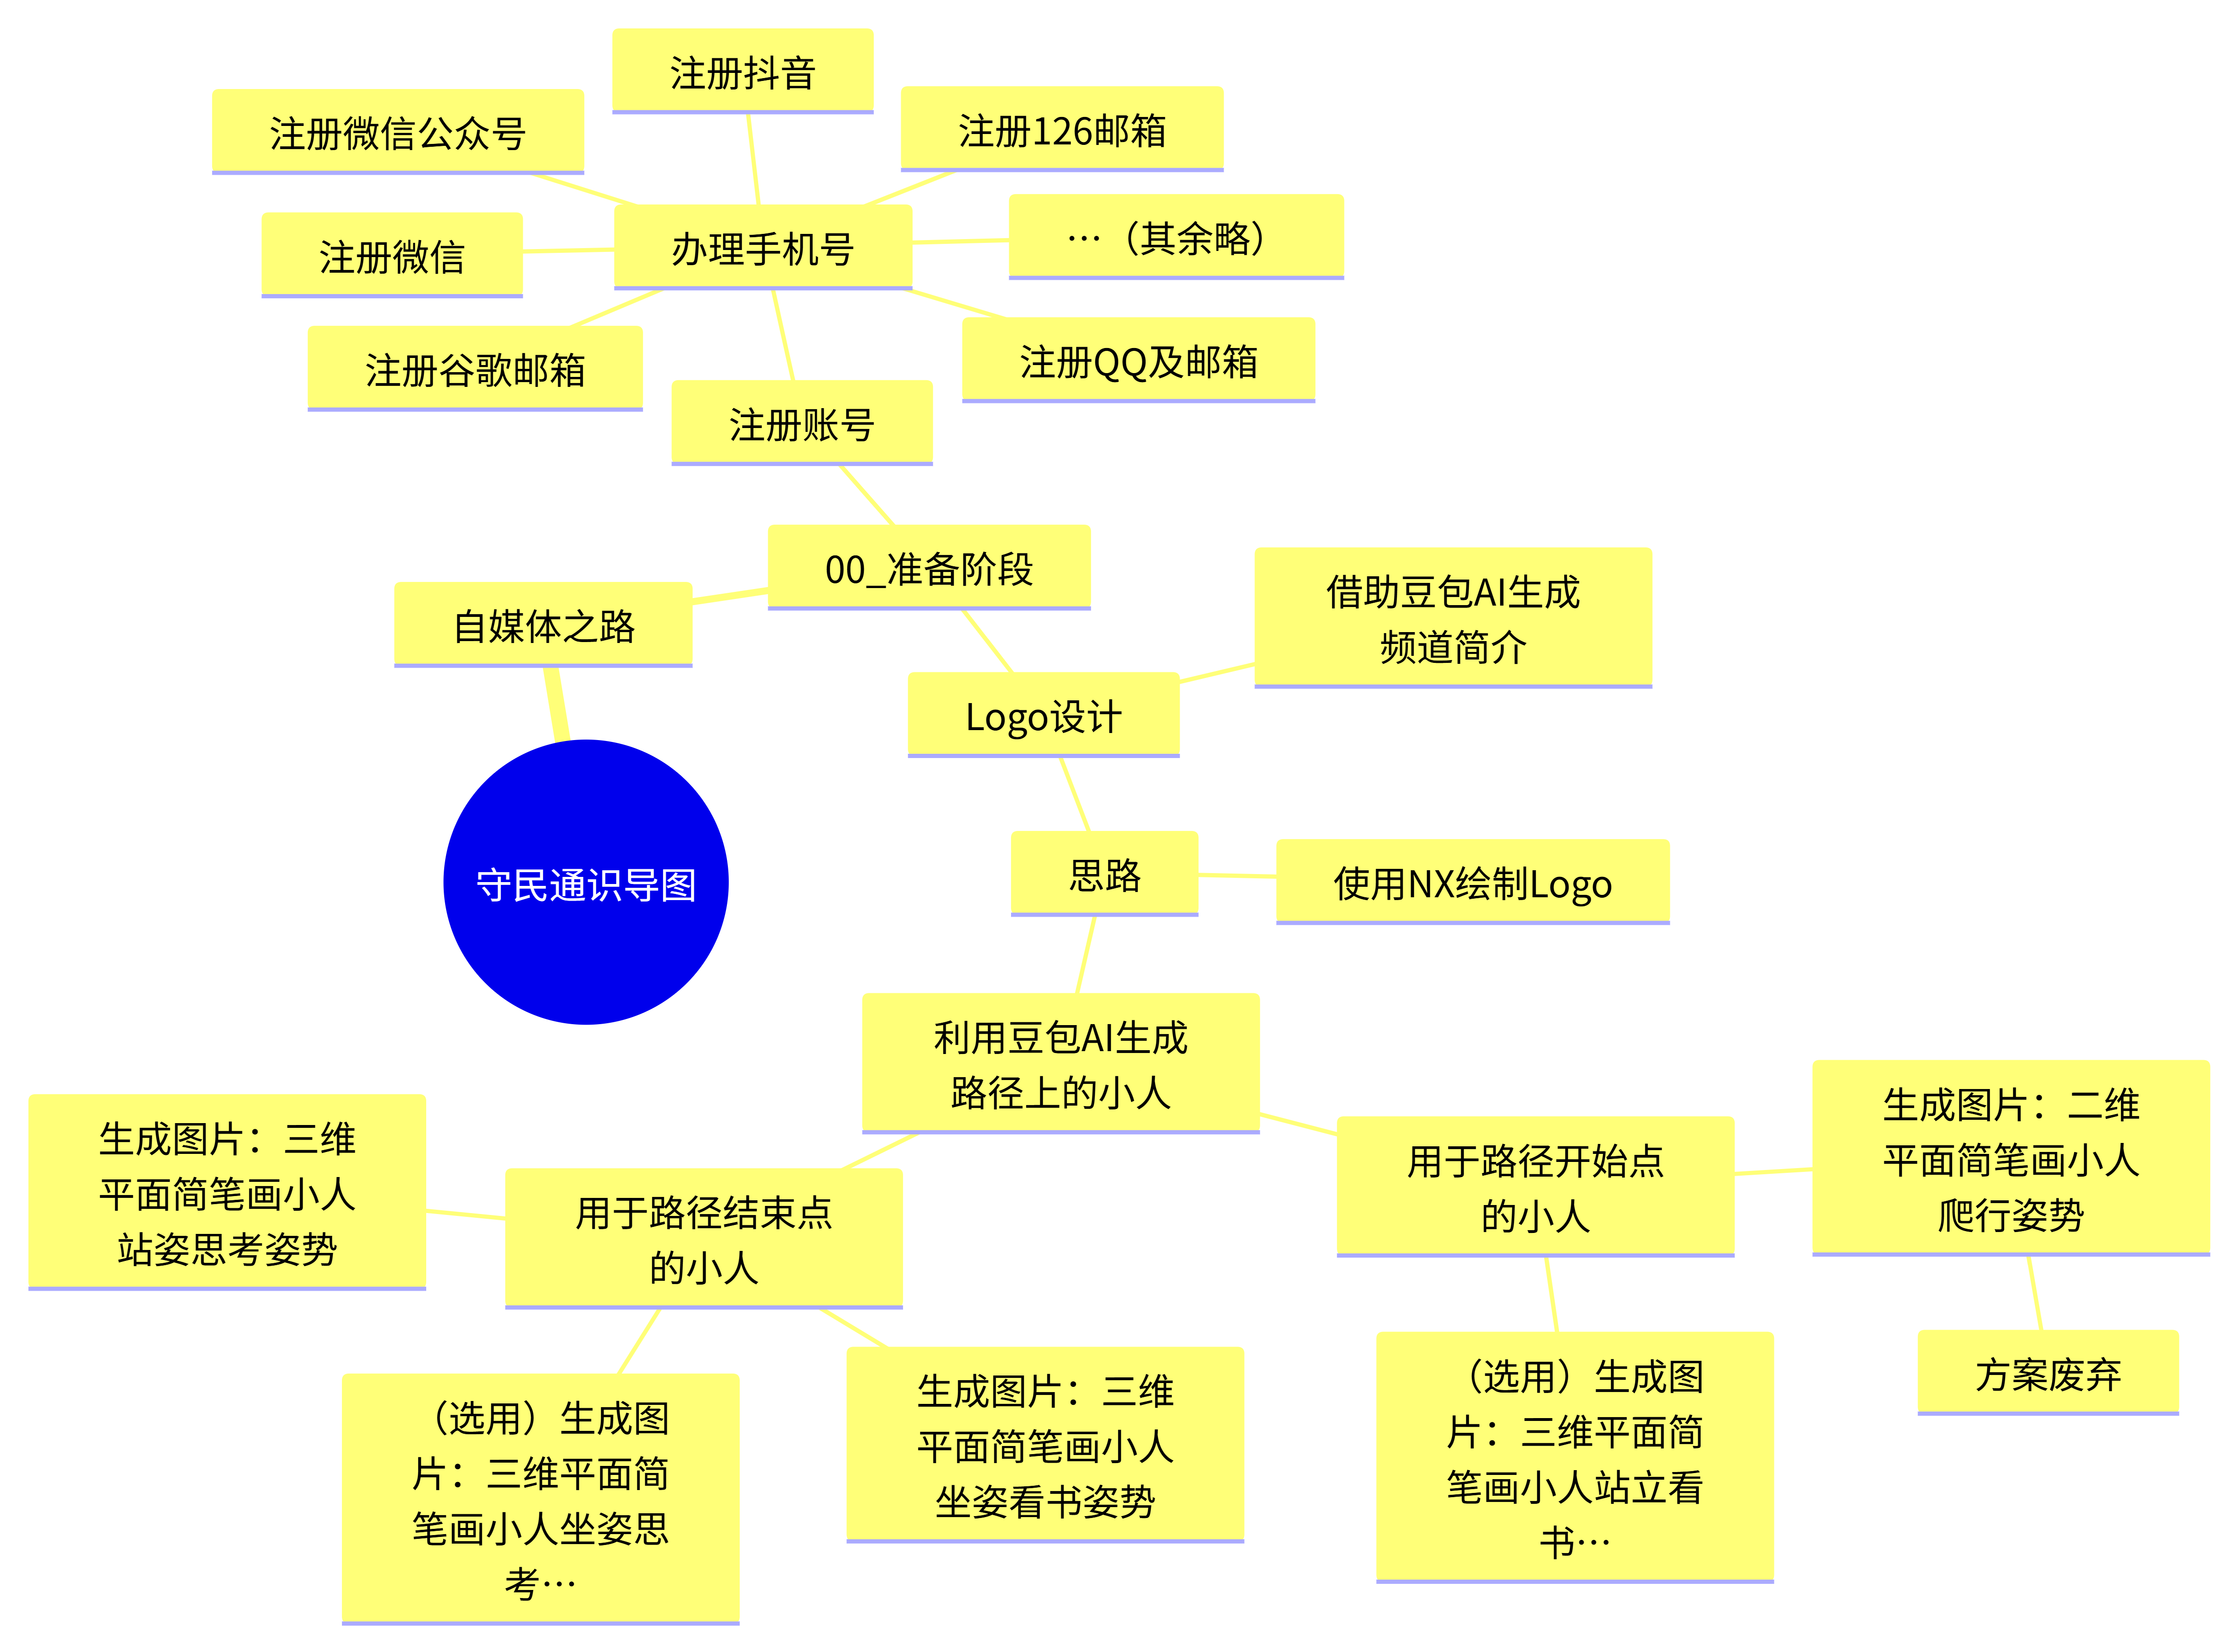
(点击图片可放大查看;滚轮缩放、按住拖拽平移,双击复位;点击空白处、右上角 × 或按 Esc 关闭)
这一节没改路径的形状,全是在它上面加:人(起点站着、终点坐着)、位置(箭头开始端、终点绿圆)、 光影(和路径同一个渲染风格)、颜色(三轮试色,形状没动)。
能带走的一条:一句话要写全四件事——用哪个文件、做成什么、谁放在哪个位置、替换掉什么。 少写一件,结果就偏一处。 偏了之后不要重写,补一句缺的那件就行。
路径只说明走得通,人说明谁在走。 字标这一关还没过,那是下一节的事。